
软件截图
4 张 · 点击查看大图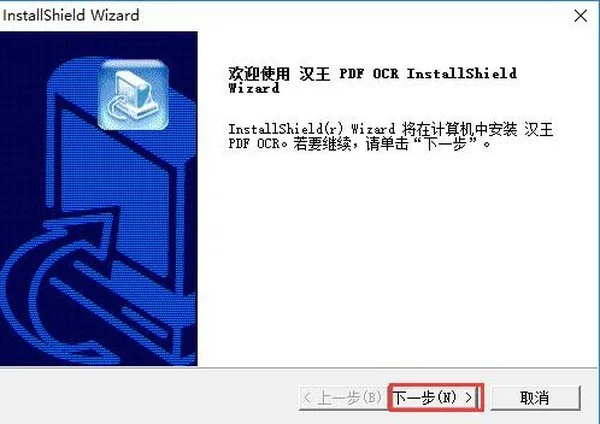
软件介绍
pdf ocr文字识别软件 是一款在 Windows 上使用的 PDF OCR 工具,核心目标是把扫描版 PDF 中的文字提取出来,变成可编辑的文本;同时它也能把多张扫描图片合成为一份扫描版 PDF。适合需要处理纸质扫描件、外文扫描文档,或希望在本机完成识别而不过多依赖其他文字处理软件的用户。
主要功能
- 扫描件转文字:识别扫描版 PDF 中的文字,输出可编辑的 TXT 文本。
- 图片转 PDF:将多张扫描图片合成为一份扫描版 PDF 文档,可用于整理成册的资料。
- 三种识别范围:支持单页、指定页码范围、整篇识别,可按实际需要选择,页面较多时不必整篇重跑。
- 内置文本编辑器:识别结果可直接在软件内修改,不必再复制到 Word 等第三方文字处理软件中校对。
- 多语言识别:除英文外,还支持德语、法语、西班牙语、意大利语等十多种识别语言。
- 批量处理:可同时加入多份文件排队处理,完成后统一导出。
- 双栏对照界面:左侧编辑文字、右侧查看原页面,便于校对时对照原稿。
- 页面尺寸覆盖较广:支持 A4、A3、B3、B4、B5 等常见扫描尺寸。
使用方法
- 获取安装包并解压,得到 exe 安装文件后双击运行,进入安装界面。
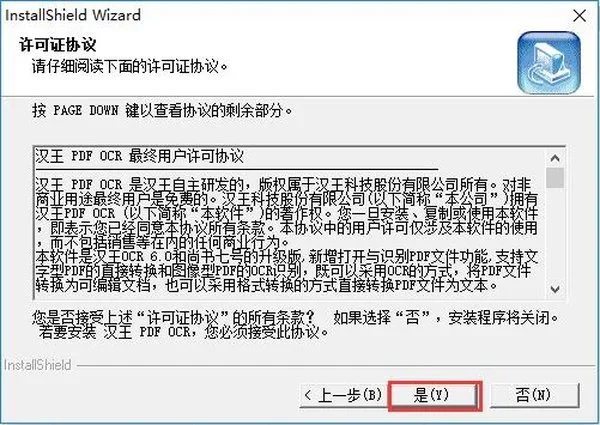
- 在许可协议界面阅读协议,选择接受后继续;若不接受,将无法完成安装。
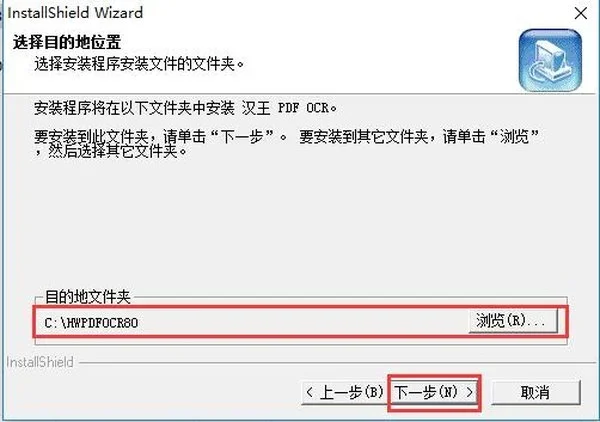
- 选择安装位置,可使用默认路径,也可通过浏览指定其他目录,然后点击下一步。
- 等待安装进度完成。
- 点击完成关闭安装界面,即可打开软件使用。
常见问题
识别结果出现错字怎么办
OCR 的准确率与扫描件清晰度关系较大。原稿建议使用 300 DPI 以上扫描,文字尽量避免倾斜、阴影和明显噪点。识别结果会显示在编辑区,错字和断行可直接在其中修改。
一次能处理多少页
软件支持单页、指定范围和整篇三种模式。页数较多时,建议先识别几页确认效果,再整篇处理,避免等待后才发现质量不理想。
界面是英文的,支持中文识别吗
界面仅有英文,但识别语言中包含中文,可在语言设置中切换。英文菜单主要包括 File、Page、Zoom、OCR、About 几项,熟悉后即可操作。
完整功能需要授权吗
软件提供安装包下载与试用,完整功能的使用方式以官方授权说明为准。本页仅做功能介绍与操作说明,不涉及授权相关操作。
注意事项
- 来源标注版本为 4.7.0,适用系统为 Windows;来源资料提及兼容 Windows 2000 至 Windows 10 等版本,实际兼容情况请以安装环境为准。
- Vista 及之后的系统建议以管理员身份启动软件。
- 识别速度与准确率受文档清晰度、页数和设备配置影响,资料中“十页以上约四十五秒”的说法仅为来源标称,未经过本站实测。
- 软件界面为英文,对不熟悉英文界面的用户可能存在一定上手成本。
软件信息
- 软件版本
- 4.7.0
- 适用系统
- Windows
- 软件分类
- 文件管理
- 授权方式
- 以官方许可为准
- 信息更新
- 软件大小
- 58.41M
- 软件语言
- 中文
- 系统要求
- win7\win8\win10\win11
- 版本资料更新
- 2026-10-23 15:04:33
- 官方网站
- 暂未提供
版本、系统要求和授权方式以开发者最新说明为准。


